
首页
/
Langextract
基本信息
- 工具类别: 开源&免费
- 收录时间: 2026-08-11
- 访问次数: 35
- 评分: 4.9
- 官网: https://github.com/google/langextract
工具详情
google/langextract 使用指南
google/langextract 是 Google 开源的 Python 库,旨在利用**大语言模型(LLM)**从非结构化文本中提取结构化信息。该工具专门解决传统大模型提取时容易丢失原文本位置定位(Grounding)的问题。以下为干货整理的使用指南:
一、平台与项目介绍
- GitHub 仓库:
google/langextract - 核心定位:基于 LLM 的文本结构化提取工具,支持精准的文本回溯(Source Grounding)与可视化显示。
- 主要优势:结合长文本切片(Chunking)、并行提取(Parallel Processing)与多轮回溯校验(Multi-pass),有效解决长文本信息漏提以及大模型提取信息时“无法定位出处”的痛点。
二、主要功能干货
- 精准原文定位(Source Grounding):提取出的字段不仅有结果,还会标注该信息在原文中的字符起始位置(
char_interval),方便核验准确性与来源依据。 - 长文本高效处理:自动切分整本小说或长篇医学报告等复杂文档,支持多线程并行(
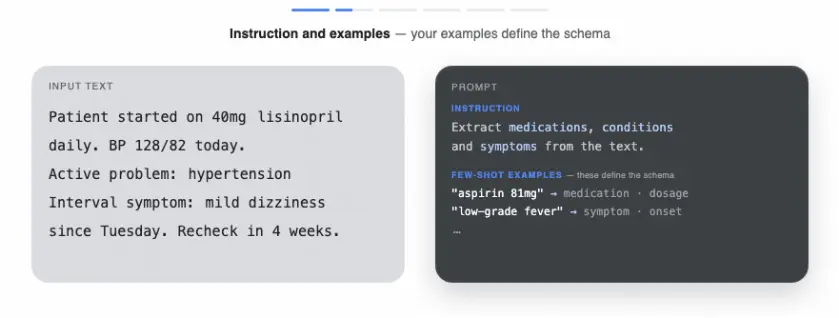
max_workers)与多轮提取(extraction_passes),从而提高整体召回率。 - 少样本驱动(Few-Shot Driven):无需微调模型,只需提供 1~2 个高质量的示例(
ExampleData),即可约束并引导输出结构符合预期。 - 交互式 HTML 可视化:可直接生成交互式 HTML 页面,在原文中将提取出的实体用高亮颜色绘制出来,直观展示提取关系与上下文位置。
- 多模型适配:原生支持 Google Gemini 系列,同时兼容 OpenAI 模型以及基于 Ollama 的本地开源大模型(如 Llama 3、Qwen 等)。
三、适用人群
- NLP / AI 工程师:需要快速从海量非结构化文本中提炼符合 Schema 的数据。
- 医疗与科研人员:提取电子病历(EMR)、放射科报告或文献中的关键指标,且对模型审计依据有严格要求的场景。
- 数据分析师 / 业务人员:处理长文档(如合同、法律条文、财务报表)并进行可视化分析的业务场景。
四、免费与付费情况
- 开源代码费用:100% 免费。采用 Apache-2.0 开源协议,可自由下载和商用源代码。
- API / 模型调用成本说明:取决于所选用的底层大模型服务商标准计费模式。
- ✅ 免费方案:使用 Ollama 部署本地模型(需自备算力),或使用 Gemini API 的 Free Tier(但有 TPM/RPM 限流)。
- 💳 付费方案:选择云端商业 API(如 Gemini 商业版、OpenAI API)或 Google Cloud Vertex AI,按对应厂商 Token / API 计费标准产生费用。
- 参考定价链接:
- Google Gemini API / AI Studio:https://ai.google.dev/pricing
- Google Cloud Vertex AI:https://cloud.google.com/vertex-ai/generative-ai/pricing
- OpenAI 定价标准:https://openai.com/api/pricing/
五、快速使用步骤
- 安装库与环境配置
bash
pip install langextract
# Windows/Linux/Mac
export GEMINI_API_KEY="your-gemini-api-key"
- Python 核心调用逻辑(Prompt & Examples)
python
import langextract as lx
import textwrap

# 1. 定义提取指令(Prompt):使用 Exact Text,保持格式一致
prompt = textwrap.dedent("""
Extract characters, emotions, and relationships. Use exact text for extractions.
""")

# 2. 提供少样本示例(引导模型对齐输出结构 & Grounding)
examples = [
    lx.data.ExampleData(
        text="ROMEO. But soft! What light through yonder window breaks? It is the east, and Juliet is the sun.",
        extractions=[
            # Extraction 字段必须与原文完全一致,禁止改写!
            lx.data.Extraction(
                extraction_class="character",
                extraction_text="ROMEO",
                attributes={"emotional_state": "wonder"}
            ),
            lx.data.Extraction(
                extraction_class="relationship",
                extraction_text="Juliet is the sun",
                attributes={"type": "metaphor"}
            ),
        ]
    )
]

# 3. 运行提取任务:输入文本与模型 ID
input_text = "Lady Juliet gazed longingly at the stars, her heart aching for Romeo"
model_id = "gemini-1.5-flash" # 推荐默认使用较新版本或指定具体型号

result = lx.extract(
    text_or_documents=input_text,
    prompt_description=prompt,
    examples=examples,
    model_id=model_id,
)

# 4. 保存结果与生成交互式可视化 HTML
lx.io.save_annotated_documents([result], output_name="results.jsonl")
html_content = lx.visualize("results.jsonl")

with open("visualization.html", "w", encoding="utf-8") as f:
    if isinstance(html_content, str):
        f.write(html_content)
    else:
        f.write(html_content.data)  # 处理返回的数据对象情况
- 数据导出与查看:运行完成后,检查生成的
results.jsonl文件包含提取结果及其字符区间信息。打开生成的 HTML 页面即可看到高亮后的原文效果。
六、注意事项
- 必须使用原文(Exact Text):在少样本示例中,
extraction_text字段严禁改写或同义替换。LLM 会尝试匹配字符区间,若与原文不符,LangExtract 将报错Prompt alignment警告并导致位置定位失效。 - Grounding 过滤机制(处理幻觉):LLM 偶尔会出现提取内容未出现在原文中的情况(Hallucination)。LangExtract 会将无法定位的项标记为
char_interval = None,建议在后处理阶段进行过滤:
python
# 示例代码片段:筛选有效字符区间的结果
valid_extractions = [e for e in result.extractions if e.char_interval]

result_filtered = lx.ExtractionData(text=input_text, extractions=valid_extractions) # 假设数据结构需重新封装以符合下游需求
- 长文本并发与 API 限流(Rate Limit):若设置较大
max_workers或多轮提取,切片后会瞬间产生大量并发请求。使用免费 API Free Tier 时极易触发 TPM/RPM 频率限制。高并发生产环境建议切换至付费层级或使用 Vertex AI Batch API 以提升稳定性。
暂无评论