
首页
/
RVC
基本信息
- 工具类别: 开源&免费
- 收录时间: 2026-08-17
- 访问次数: 53
- 评分: 4.0
- 官网: https://github.com/RVC-Project/Retrieval-based-Voice-Conversion-WebUI
工具详情
RVC
1. 平台介绍
Retrieval-based Voice Conversion WebUI (RVC) 是一个开源的 V2V(Voice-to-Voice,语音到语音) 声音变换与克隆框架。它基于 VITS 架构 与 基于特征检索(Retrieval-based) 的技术改进,核心能力在于能够把源音频的音色替换为目标 Speaker 的音色,同时保留原语音的 语调、情感和节奏。
2. 主要功能
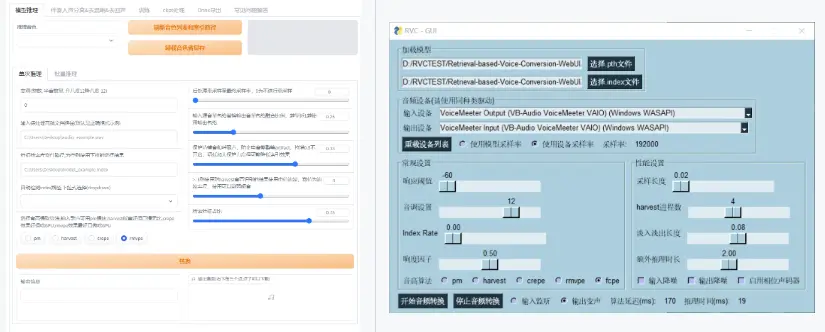
- 推理转换(AI 翻唱 / 变声):支持上传干声/语音并选择模型以生成目标音色的音频。用户可调整 变调(Pitch)、变音算法(如 RMVPE, PM, Harvest, Crepe)及音色融合度。
- 模型训练(声音克隆):仅需 10~20 分钟 干净的目标语音干声即可训练出专属音色模型。
- 实时变声(GUI):配合虚拟音频线(如 VB-Cable)与低延迟驱动(ASIO),可在 Discord、游戏、直播等场景中实现低延迟实时变声。
- 辅助工具:
- 人声伴奏分离:内置人声与伴奏切分工具。
- 模型融合(Ckpt Merge):可将多个音色权重进行比例叠加,混合出新的音色。
3. 适用人群
- VTuber / 游戏主播 / 内容创作者:用于实时变声或制作角色语音包。
- AI 音乐爱好者:用于制作 AI 歌手翻唱(AI Cover)。
- 配音员 / 音频工程师:用于修正人声音效或做音色替换。
4. 免费/付费情况
- 完全免费与开源:项目基于 MIT 许可证 开源,费用为 100% 免费,支持离线部署运行。
- 源码与更新地址:项目托管于 GitHub - RVC-Project/Retrieval-based-Voice-Conversion-WebUI。
5. 如何使用(快速上手指南)
硬件与环境准备
- 操作系统:支持 Windows / Linux / macOS。
- 硬件建议:推荐使用 NVIDIA 显卡(建议 6GB 及以上显存;纯 CPU 可运行但推理/训练极其缓慢)。
下载与启动
- 从 GitHub Release 页面下载整合包(预安装环境与依赖)。
- 解压后点击
go-webui.bat启动 WebUI 界面,默认会自动打开浏览器访问 http://127.0.0.1:7865。 - (如需实时变声)运行
go-realtime_gui.bat。
音色推理(转换声音)
- 切换到 “模型推理” 选项卡。
- 将训练好的 .pth 模型文件放入
assets/weights/目录,将对应 .index 文件放入assets/indices/。 - 点击“刷新音色列表”,选择目标模型。
- 上传需要转换的音频文件。
- 调节关键参数:
- 变调(Pitch/Key):男声变女声通常设置为 +12,女声变男声 -12;若是同性别翻唱保持 0。
- 音高提取算法:优先推荐 RMVPE(效果最好且速度快、不哑音)。
- 检索特征占比:建议保持 0.6 - 0.75,防止漏音。
- 点击 “转换” 并导出音频。
模型训练(自制音色)
- 切换到 “训练” 选项卡。
- 步骤 1:输入实验名称,选择采样率(推荐 40k/48k)与是否包含音高 F0。
- 步骤 2a:指定训练干声文件夹路径,点击“处理数据”。
- 步骤 2b:选择 RMVPE 算法提取特征和音高。
- 步骤 3:设置总训练轮数(Epoch,建议 100~300),点击“训练模型”与“训练特征索引”。
6. 注意事项
- 数据质量决定一切:训练素材务必使用无噪音、无伴奏、无重度混响的 干净干声。有杂音的数据会导致输出有电音或破音。
- 版权与肖像权安全:切勿将未经授权的他人音色模型用于公开发布、商业用途或欺诈行为。
- 算法选择:推理和提取音高时优先使用 RMVPE。以前常用的
Harvest耗时极长,PM容易变哑音。 - 路径不能包含中文:存放 RVC 项目文件及音频数据集的目录路径中 严禁包含中文或特殊字符,否则容易引发 PyTorch 加载报错。
暂无评论