
首页
/
VoiceStudio
基本信息
- 工具类别: 视频音频
- 收录时间: 2026-09-14
- 访问次数: 9
- 评分: 4.2
- 官网: https://github.com/debpalash/VoiceStudio
工具详情
VoiceStudio 使用指南
一、平台介绍
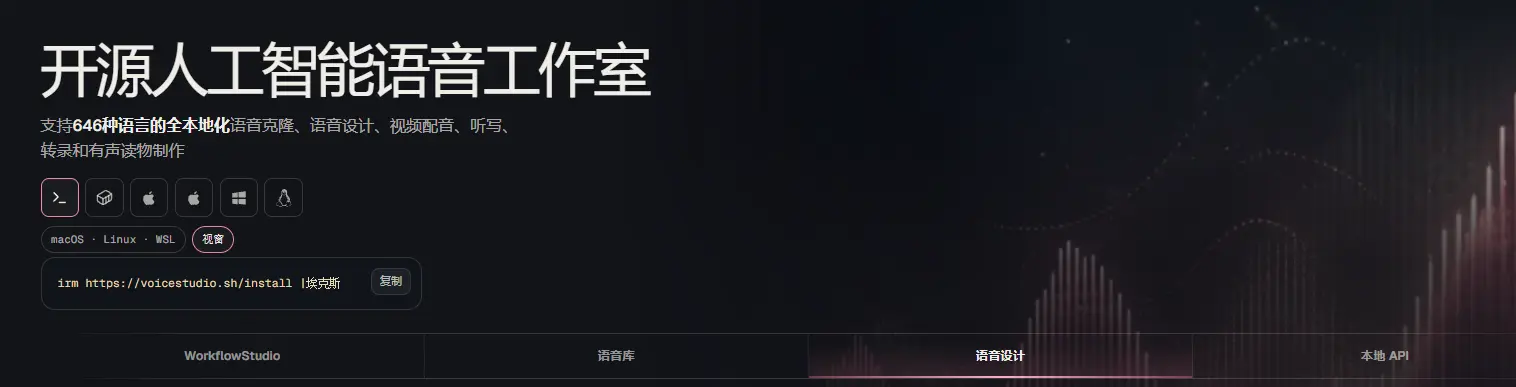
VoiceStudio 是一个开源且完全本地化运行的 AI 声音工作站。该工具被定位为 ElevenLabs 的开源替代品,具有以下核心特点:
- 数据隐私保护: 所有数据、声音模型和生成内容均保存在用户自身的本地设备上,无需依赖云端服务,有效保护隐私。
- 完全本地运行: 避免了将敏感语音或商业机密文本上传至第三方平台的潜在风险。
- 多功能集成: 集成了 TTS(文本转语音)与 ASR(语音识别)引擎,支持从录音到生成内容的完整工作流。
二、主要功能特性
平台提供了强大的处理能力,具体功能包括:
- 声音克隆与设计 (Voice Cloning & Design): 用户可通过一段音频样本快速克隆特定声音,或自定义调节参数创建全新的 AI 声音。
- 视频自动配音 (Video Dubbing): 支持导入视频/音频文件或 URL,自动提取字幕并将其翻译为目标语言,同时保留原说话者的音色生成新配音。
- 有声书与多角色创作 (Audiobook Creation & Multi-Speaker): 内置剧本编辑器,支持多角色分配与音色映射,可一键生成完整的有声书内容。
- 实时听写与语音转文字 (Dictation & Transcription): 支持多语言的高精度语音识别服务。
- 多模型与多语言支持: 支持多达 16 种 TTS 引擎与 11 种 ASR 引擎,覆盖高达 646 种语言。
- 开发者接口: 提供本地 REST / SSE / WebSocket API、OpenAI 兼容的 Audio API 以及 MCP Server,便于接入应用或自动化工作流。
三、适用人群
该工具适合以下类型的用户群体:
- 自媒体与视频创作者: 需要进行多语言视频翻译、跨国配音及自动生成字幕的用户。
- 有声书/广播剧创作者: 需要处理长文本朗诵及多角色音色快速分配的制作人。
- 开发者与 AI 爱好者: 需要将本地 TTS/ASR 服务接入应用、Agent 或个人自动化工作流的技术人员。
- 高隐私需求用户: 无法接受数据上传至云端,有严格保密要求的用户。
四、免费与付费情况
关于许可协议、成本及硬件门槛的说明:
- 许可与价格: 项目为 100% 免费且开源,遵循 AGPL-3.0 开源协议。无需订阅或按字数付费。
- 官方定价策略: 官方项目无付费版本,不存在官方的付费定价页面。如需随时了解项目状态或赞助作者,可直接前往 GitHub 仓库查看。
- 硬件要求: 本地运行需消耗自身算力,支持 NVIDIA CUDA、Apple Silicon MPS/MLX、Linux ROCm 或 CPU 运行。建议配置 8GB 以上显存(或 Mac 统一内存)以获得流畅的生成速度。
- 模型许可证提示: 虽然软件本身开源,但通过界面下载的某些第三方模型可能保留各自的上游许可证(如非商业用途限制),商业化使用前需注意确认具体模型条款。
五、如何使用
- 环境准备与克隆: 需准备好 Python 环境与 Git 工具,执行以下命令下载代码:
- bash
git clone https://github.com/debpalash/VoiceStudio.git
cd VoiceStudio
- 安装依赖: 根据硬件配置(如 Nvidia GPU / Mac M 芯片 / CPU),安装对应的 PyTorch 及依赖项:
- bash
pip install -r requirements.txt
- 启动应用: 运行启动脚本以打开桌面界面或 Web UI。系统支持快捷键
Ctrl / Cmd + E来切换引擎、下载或加载模型。
六、注意事项
在使用前请务必关注以下细节:
- 资源消耗: 高精度克隆与跨语言配音引擎对显存要求较高,低配置设备可能导致生成速度变慢。
- 首次预热时间: 首次运行时需下载模型权重文件,可能耗时较长,请确保网络连接通畅。
- 合规性风险: 务必遵守所加载模型的许可协议,避免在商业环境中使用受限的第三方模型资源。
暂无评论